제미나이 3.8 라이브가 오늘 새벽 공개되면서 실시간 AI 에이전트 경쟁이 본격화됐습니다. [R-01]
구글이 오늘 새벽 모델 두 개를 공개했습니다. 실시간 음성을 다루는 모델과, 오래 생각하는 모델인데요. 숫자보다 이 조합이 더 중요합니다. 그동안 음성 에이전트를 붙일지 고민하는 팀들이 늘 마주하던 질문이 두 가지 있었습니다. 응답이 얼마나 빨리 나오냐, 그리고 그 답을 얼마나 믿을 수 있냐죠. 이 둘은 지금까지 서로 반대편에 있었습니다. 빠르게 답하면 얕아지고, 깊게 생각하면 느려졌기 때문입니다. 그래서 많은 팀이 음성은 간단한 안내에만 써왔는데, 오늘 발표는 바로 그 지점을 건드립니다. [R-01]
제미나이 3.8 라이브, 오늘 실제로 나온 것
발표 내용
구글 딥마인드가 제미나이 3.8 라이브를 공개했습니다. [R-01] 같이 나온 모델 이름은 3.8 라이브 익스텐디드 싱킹입니다. [R-01] 익스텐디드 싱킹은 우리말로 확장 추론 정도로 옮길 수 있습니다. [R-01] 공개 시각은 한국 시간으로 오늘 새벽 두 시 오 분이었습니다. [R-01] 두 모델 모두 실시간 음성과 확장 추론을 지원한다고 소개됐습니다. [R-01]
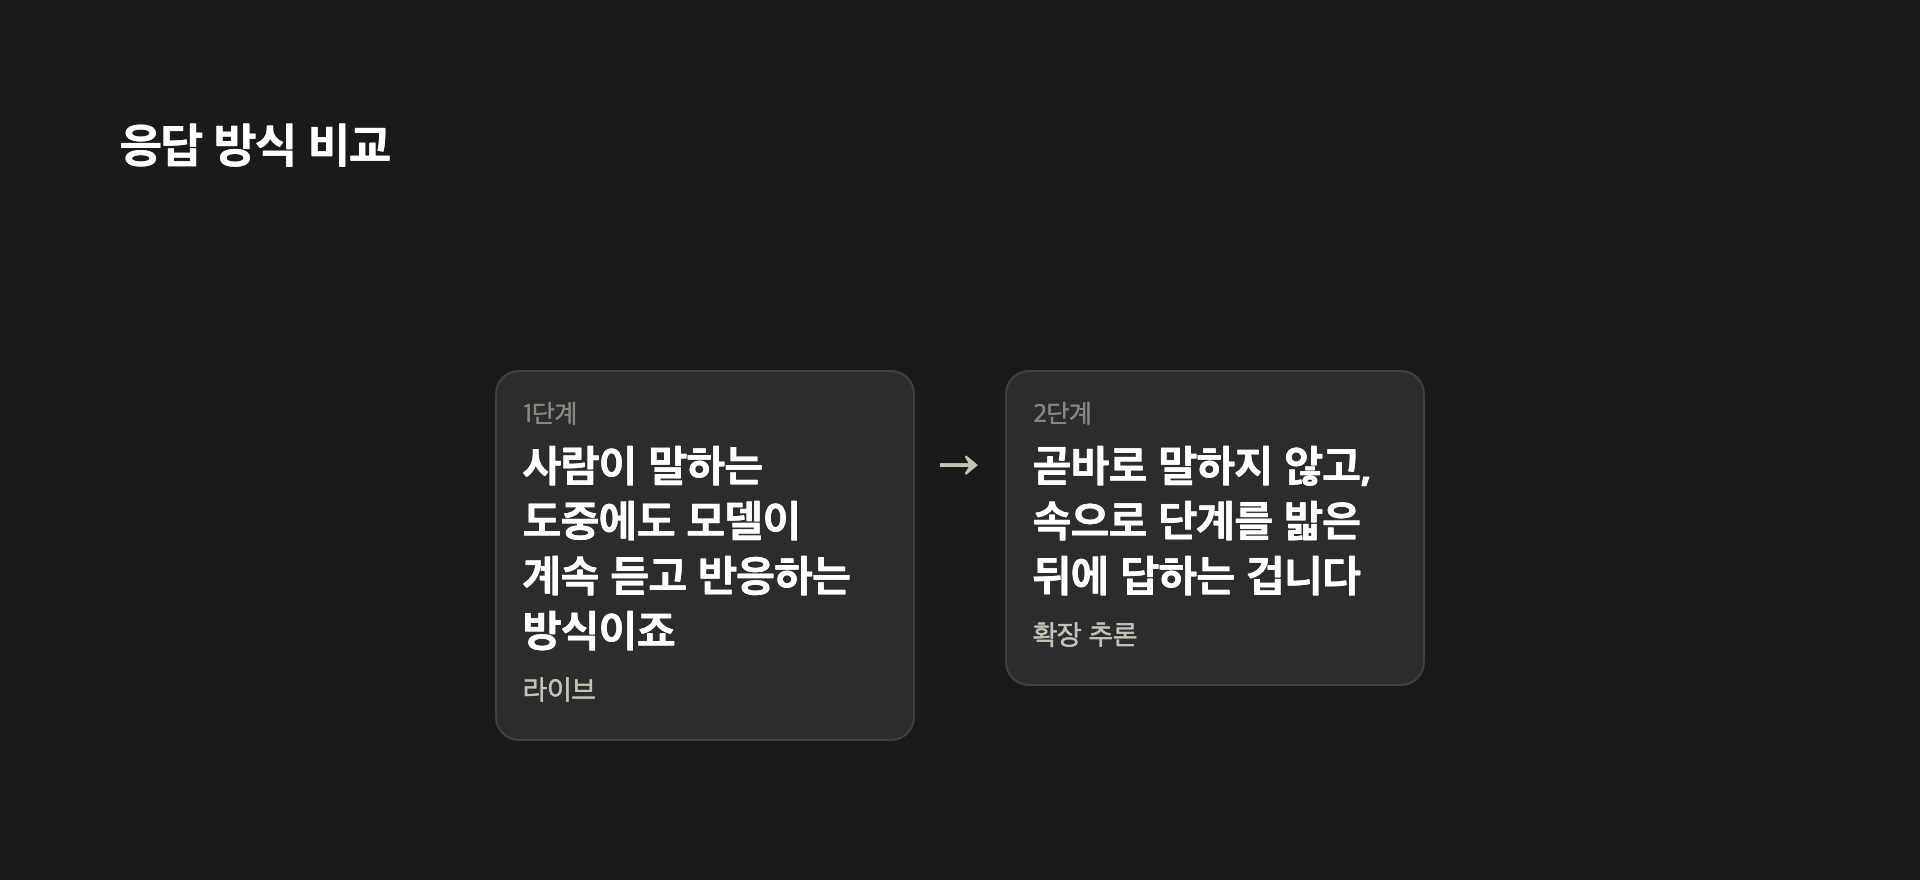
라이브는 사람이 말하는 도중에도 모델이 계속 듣고 반응하는 방식으로, 전화 통화에 가깝습니다. 질문이 끝나기를 기다렸다가 답하는 구조와는 다릅니다. 반대로 확장 추론은 답을 잠시 미루고 속으로 단계를 밟은 뒤 답하는 기능입니다. 두 성질은 사실 정반대 방향을 봅니다. 하나는 기다리지 않는 쪽이고, 하나는 기다리는 쪽입니다. 그 둘을 한 제품군에 같이 넣었다는 게 이번 공개의 특징입니다. 구글은 확장 추론을 결합한 첫 라이브 모델이라는 점을 내세웠습니다. [R-01] 배경으로는 실시간 멀티모달 에이전트 경쟁이 꼽힙니다. [R-01] 멀티모달은 말과 이미지, 소리를 함께 받는다는 뜻이고, 에이전트는 사람 대신 여러 단계를 처리하는 프로그램입니다. 음성으로 그 일을 시키려면 빨리 반응하는 능력과 틀리지 않게 판단하는 능력이 동시에 필요합니다. 이번 소식은 그 둘을 한 자리에 모은 시도로 볼 수 있습니다. 다만 이름만으로 성능을 판단할 수는 없으므로, 성능 자랑보다 어떤 요청에 즉답을 주고 어떤 요청에 시간을 쓸 것인가라는 구조 변화에 주목할 필요가 있습니다.
왜 하필 지금 겹쳐서 터지나
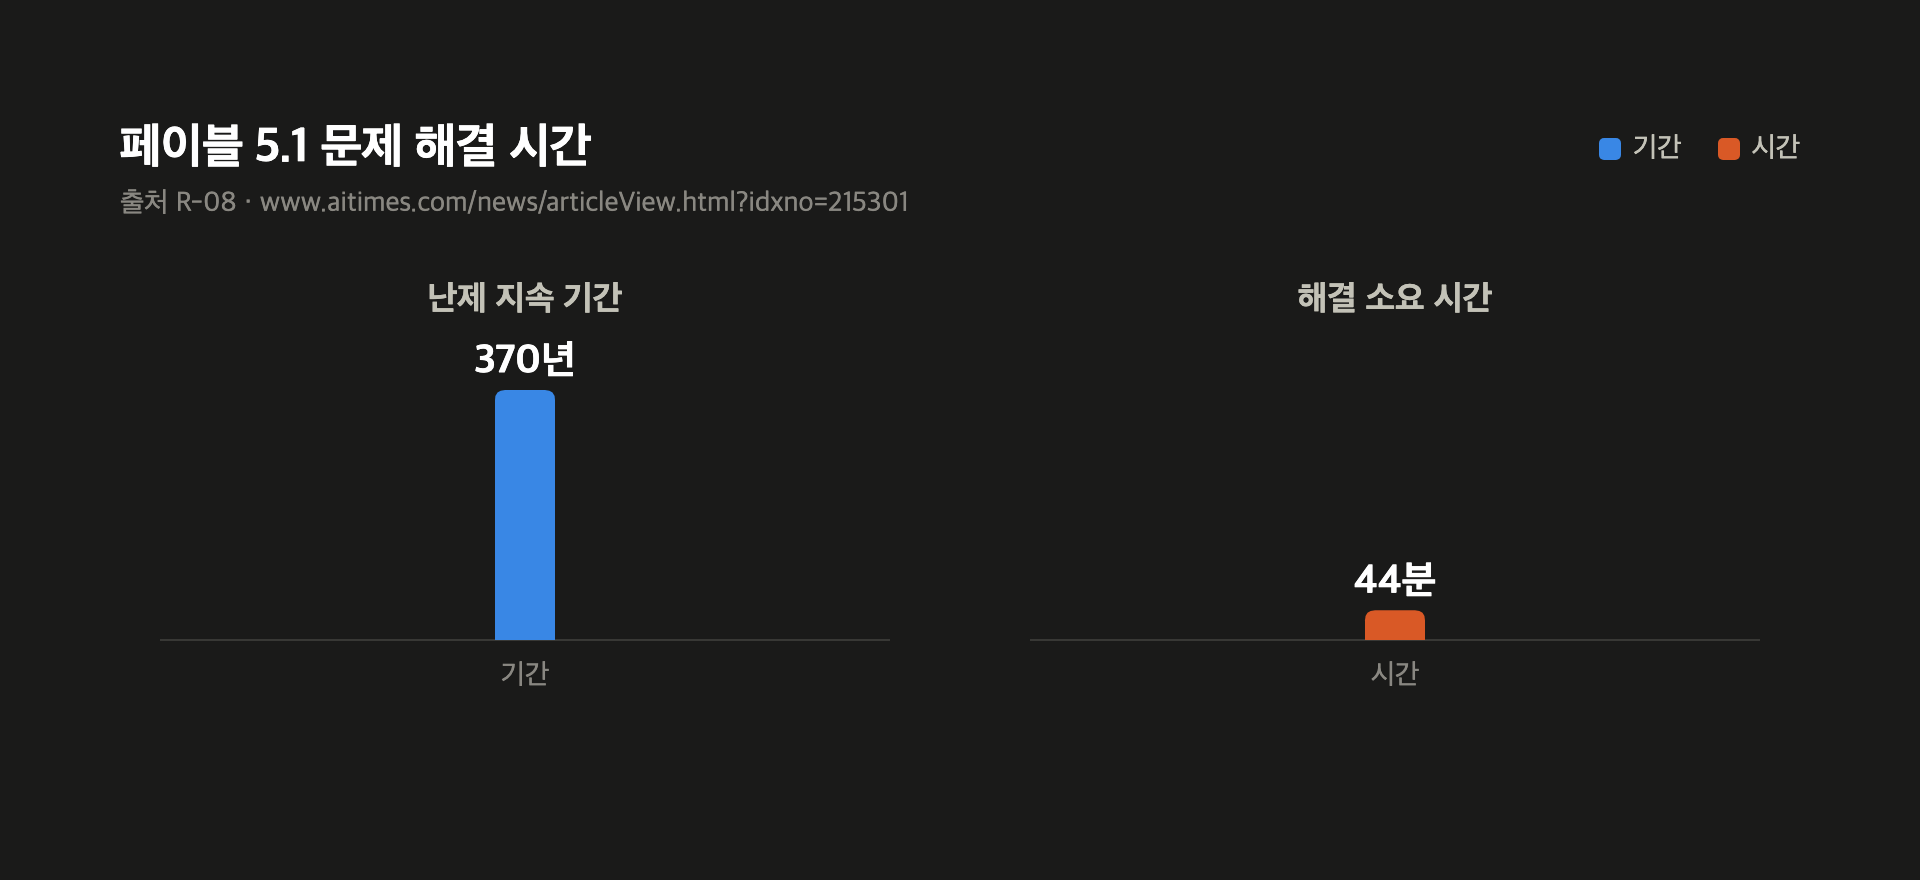
같은 시점에 앤트로픽의 새 모델 페이블 5.1이 화제가 됐습니다. [R-08] 이 모델이 370년 동안 풀리지 않은 암호 난제를 풀었는데, 걸린 시간은 44분이었습니다. [R-08] 한쪽은 깊이를 보여줬고 한쪽은 속도를 내세운 셈이라, 업계가 두 축을 동시에 밀고 있다는 신호로 읽힙니다.
인터페이스 쪽도 같은 방향입니다. 애플은 시리에 인공지능 기능을 넣은 iOS 27 배포를 시작했고, 차세대 아이폰 출시도 함께 준비하고 있습니다. [R-11] 오픈AI는 아이폰 카메라 기술을 만든 스타트업을 인수하며 AI 하드웨어 사업을 넓히려는 행보를 보였습니다. [R-09]
모델, 단말, 인터페이스가 같이 움직이면서 응답 지연이 곧 제품 품질이 되고 있습니다. 화면에서는 몇 초를 기다려도 크게 불편하지 않지만, 대화에서는 그 침묵이 훨씬 길게 느껴집니다. 그래서 기준이 두 갈래로 갈릴 것으로 보입니다. 간단한 질문은 즉시, 복잡한 요청은 잠깐 생각한 뒤 답하는 식입니다. 문제는 그 분기를 누가 결정하느냐입니다. 모델에 맡기면 편하지만 왜 느렸는지 설명하기 어려워지고, 사용자에게 맡기면 명확하지만 대화 흐름이 끊깁니다. 당분간은 서비스가 직접 규칙을 정하는 편이 안전해 보입니다. 다만 난제를 푼 사례가 곧바로 우리 서비스 품질을 뜻하진 않습니다. 연구용 과제와 고객 응대는 요구되는 성질이 다르기 때문에, 성능 기사보다 직접 시나리오 테스트가 더 믿을 만합니다.
국내 제도와 실무 준비
AI 기본법 개정안이 국회 과방위 소위를 통과했습니다. [R-10] 정부 지원으로 만든 AI 데이터를 한곳에 모으는 내용이 담겼고, 법 논의가 실제 입법 단계로 들어섰습니다. [R-10] 음성 에이전트는 통화 내용과 대화 기록을 다루기 때문에 데이터 출처를 설명할 일이 늘어난다고 봅니다. 기본 음성 비서가 먼저 똑똑해지면 기대치가 같이 올라가고, 우리 서비스 음성 응답이 상대적으로 답답하게 느껴질 수 있는데 이는 생각보다 빨리 체감될 수 있습니다.
실무에서 먼저 걸리는 건 언제나 비용과 지연시간입니다. AWS는 아마존 베드록의 프롬프트 캐싱 활용법을 안내했습니다. [R-05] 같은 프롬프트를 다시 계산하지 않고 재사용해 비용과 지연시간을 함께 줄이는 방식입니다. [R-05] 실시간 음성일수록 이런 기본 최적화가 먼저이며, 확장 추론은 생각하는 만큼 시간과 요금이 따라붙기 때문에 언제 깊게 생각시킬지 정하는 설계가 필요합니다.
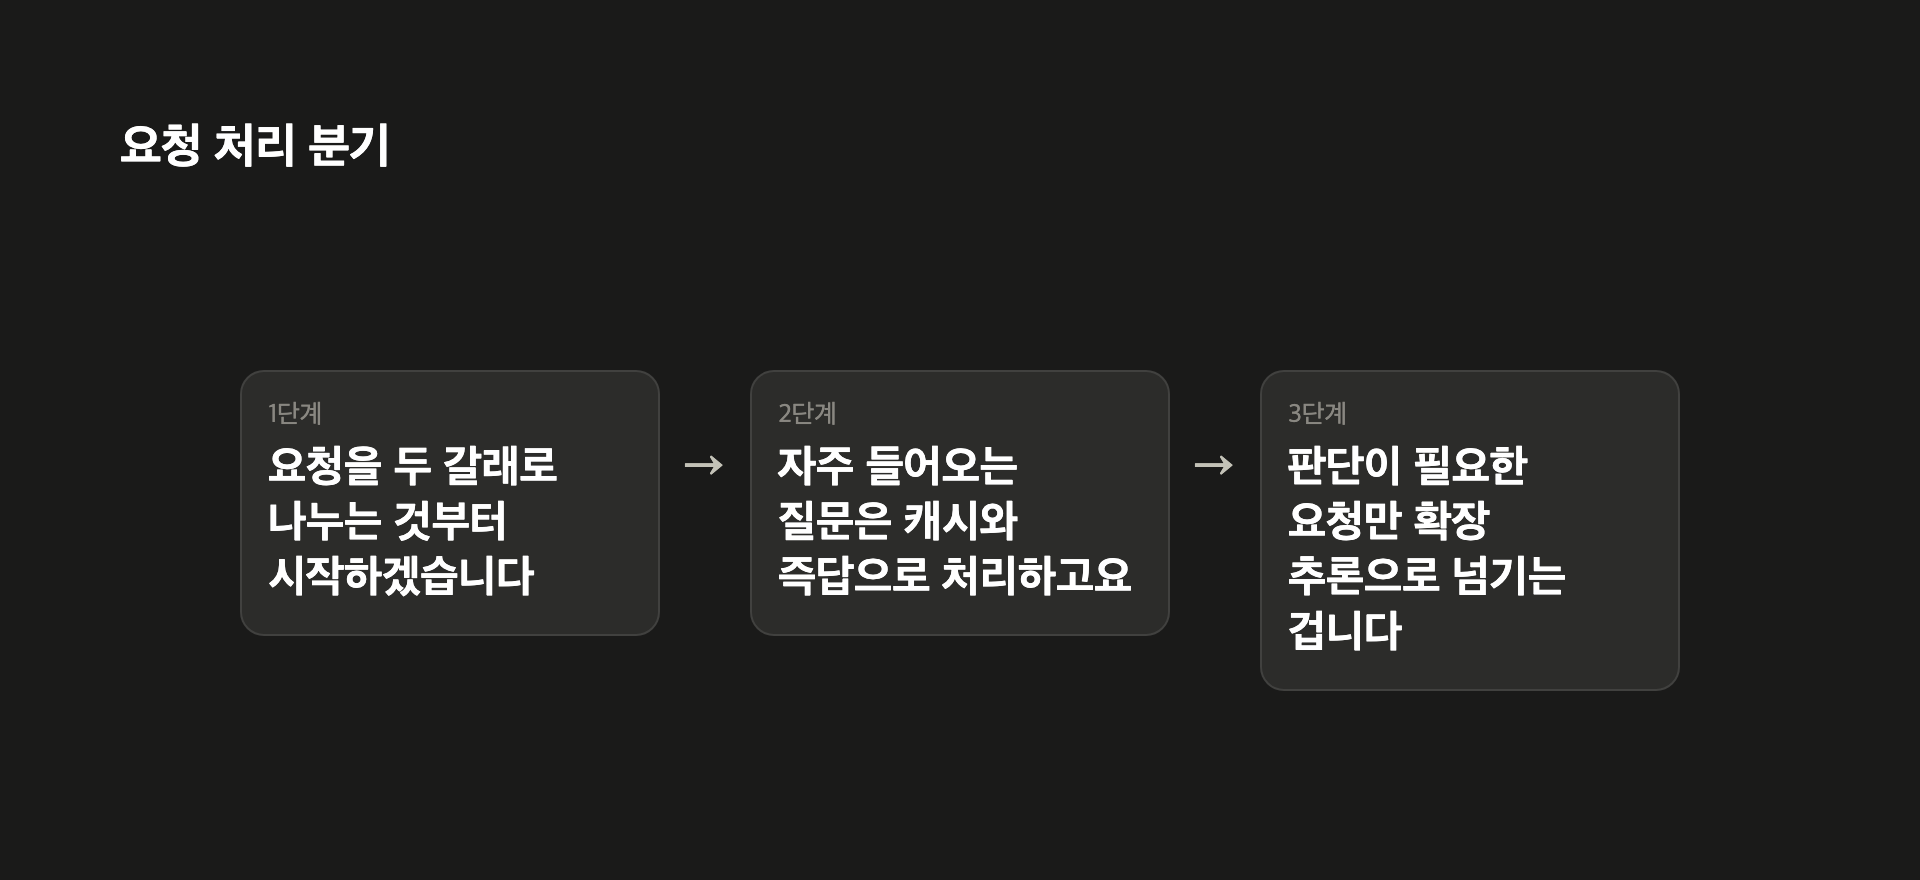
요청을 두 갈래로 나누는 것부터 시작하는 게 좋습니다. 자주 들어오는 질문은 캐시와 즉답으로 처리하고, 판단이 필요한 요청만 확장 추론으로 넘기는 겁니다. 검증은 음성 없이 텍스트로 먼저 해보는 것이 좋은데, 음성은 문제가 생겨도 어디서 틀렸는지 찾기 어렵기 때문입니다. 그리고 한국어 발화 데이터로 직접 확인하는 것이 중요합니다. 영어 시연 영상만 보고 판단하면 나중에 후회할 수 있습니다. 새 모델이 나왔다고 바로 전면 교체할 필요는 없고, 기존 흐름에서 좁은 구간 하나만 먼저 바꿔보는 접근이 안전합니다.
정리하면, 구글이 실시간 음성과 확장 추론을 함께 내놨고 [R-01], 같은 시기에 단말과 인터페이스도 함께 움직였으며 [R-09][R-11], 국내에서는 데이터 관련 제도 논의가 진행 중입니다. [R-10] 오늘 소식만으로 성능을 단정할 수는 없으니, 우리 시나리오로 직접 재보는 것이 유일한 답이라고 봅니다.
출처
- [R-01] 구글 딥마인드 제미나이 3.8 라이브 발표 — https://deepmind.google/blog/introducing-gemini-3-8-live-and-3-8-live-extended-thinking/
- [R-05] AWS 베드록 프롬프트 캐싱 안내 — https://aws.amazon.com/blogs/machine-learning/optimizing-cost-and-latency-with-amazon-bedrock-prompt-caching/
- [R-08] 앤트로픽 페이블 5.1 암호 난제 해결 — https://www.aitimes.com/news/articleView.html?idxno=215301
- [R-09] 오픈AI 아이폰 카메라 스타트업 인수 — https://www.aitimes.com/news/articleView.html?idxno=215285
- [R-10] AI 기본법 개정안 국회 소위 통과 — https://www.bloter.net/news/articleView.html?idxno=673688
- [R-11] 애플 iOS 27 배포 시작 — https://www.aitimes.com/news/articleView.html?idxno=215300
 ydhom26-hetip

댓글 남기기